
Apple vừa công bố một nghiên cứu mới, giới thiệu kỹ thuật giúp tăng tốc phản hồi của các mô hình ngôn ngữ lớn (LLM) mà vẫn giữ nguyên chất lượng đầu ra. Công nghệ này hứa hẹn rút ngắn đáng kể thời gian xử lý, đặc biệt trong các tác vụ toán học và lập trình.
Chi tiết kỹ thuật
Thông thường, LLM tạo văn bản theo từng token một. Quá trình này chậm vì mỗi bước phải dựa vào toàn bộ các token trước đó để đảm bảo câu trả lời mạch lạc và chính xác.
Ví dụ, khi viết câu “Con mèo màu đen”, mô hình sẽ dự đoán từng token liên tiếp. Sau khi viết “Con mèo màu”, nó sẽ dựa vào toàn bộ ngữ cảnh (bao gồm yêu cầu ban đầu của người dùng và các mẫu đã học trong quá trình huấn luyện) để tính xác suất cho từng token tiếp theo trong kho từ vựng. Cách hoạt động này được gọi là autoregression.
Trong tình huống đó, mô hình có thể cân nhắc các lựa chọn như “đen”, “trắng”, “ngủ”, “béo”, “lông xù”… rồi chọn từ phù hợp nhất với ngữ cảnh.
Apple đã làm gì
Trong nghiên cứu mang tên Your LLM Knows the Future: Uncovering Its Multi-Token Prediction Potential, nhóm của Apple phát hiện rằng dù LLM thường được huấn luyện để dự đoán token tiếp theo, chúng vẫn lưu giữ thông tin hữu ích về nhiều token sắp tới.
Từ đó, Apple phát triển khung “multi-token prediction” (MTP) cho phép mô hình tạo nhiều token cùng lúc. Cách làm này gợi nhớ tới nghiên cứu về mô hình diffusion, dù quy trình huấn luyện và công nghệ nền tảng khác nhau. Điểm chung là đều nhằm tăng tốc độ suy luận, thay vì phải đi từng token.
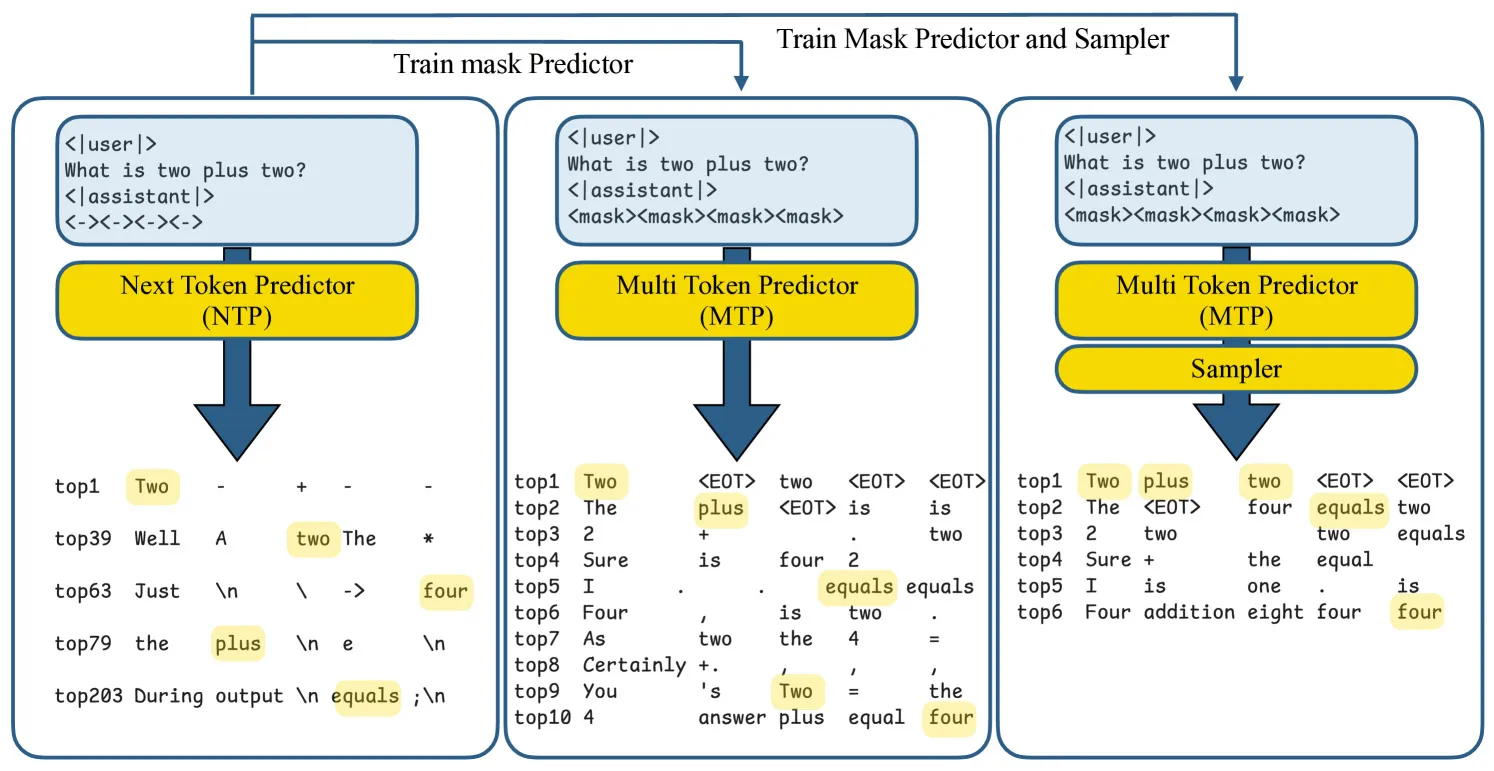
Trong thí nghiệm, các nhà nghiên cứu chèn token đặc biệt “mask” vào câu lệnh — đóng vai trò như chỗ trống cho các từ sẽ xuất hiện. Ví dụ, câu “Con mèo rất <MASK1> <MASK2>” có thể được điền ngay thành “lông xù” chỉ trong một bước. Mô hình sẽ suy đoán trước nhiều từ và kiểm tra ngay với kết quả của phương pháp dự đoán tuần tự thông thường. Nếu dự đoán sai, nó sẽ quay lại quy trình từng token để đảm bảo độ chính xác.
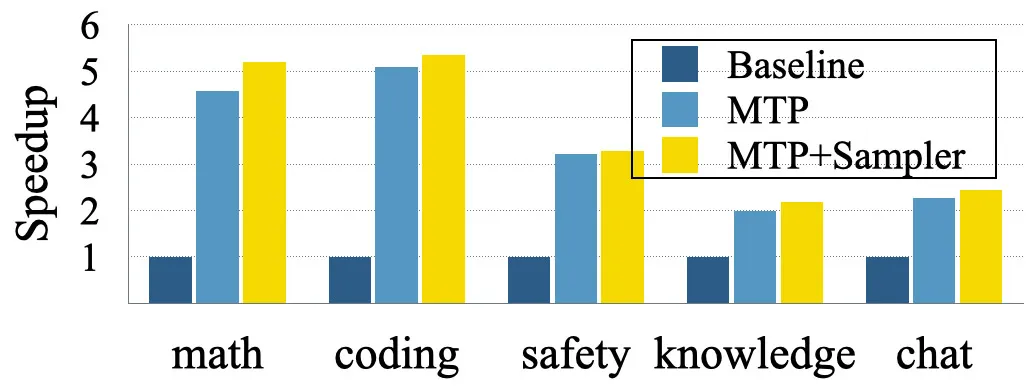
Apple thử nghiệm trên mô hình mã nguồn mở Tulu3-8B, huấn luyện để dự đoán thêm 8 token. Kết quả cho thấy tốc độ trung bình tăng 2–3 lần ở các tác vụ chung như hỏi đáp và trò chuyện, và lên tới 5 lần ở các lĩnh vực có tính dự đoán cao như lập trình và toán học. Nhờ kỹ thuật “gated LoRA adaptation”, hiệu suất này đạt được mà không làm giảm chất lượng đầu ra.
Bạn có thể đọc toàn bộ nghiên cứu trên arXiv để biết thêm.