
Apple vừa công bố bộ dữ liệu nghiên cứu mang tên Pico-Banana-400K, gồm hơn 400,000 hình ảnh được tuyển chọn kỹ lưỡng nhằm phục vụ việc huấn luyện các mô hình AI chỉnh sửa ảnh. Đáng chú ý, dự án này được xây dựng với sự hỗ trợ của mô hình Gemini-2.5 do Google phát triển, cho thấy hướng tiếp cận cởi mở hơn của Apple trong nghiên cứu trí tuệ nhân tạo.
Apple phát hành bộ dữ liệu Pico-Banana-400K
Theo nhóm nghiên cứu của Apple, Pico-Banana-400K là bộ dữ liệu quy mô lớn được thiết kế dành riêng cho lĩnh vực “chỉnh sửa ảnh dựa trên mô tả văn bản” (text-guided image editing). Bộ dữ liệu này đi kèm giấy phép phi thương mại, cho phép các tổ chức và nhà nghiên cứu sử dụng cho mục đích học thuật hoặc phát triển AI, nhưng không được dùng trong các sản phẩm thương mại.
Trong bài nghiên cứu đăng tải trên arXiv, Apple cho biết Pico-Banana-400K được tạo ra nhằm khắc phục tình trạng thiếu hụt các bộ dữ liệu mở có chất lượng cao trong lĩnh vực này. Phần lớn các tập dữ liệu hiện nay vẫn phụ thuộc vào ảnh tổng hợp từ mô hình độc quyền hoặc các tập nhỏ do con người lựa chọn thủ công, dẫn đến sự mất cân bằng và khó đảm bảo chất lượng.
Cách Apple tạo ra bộ dữ liệu này
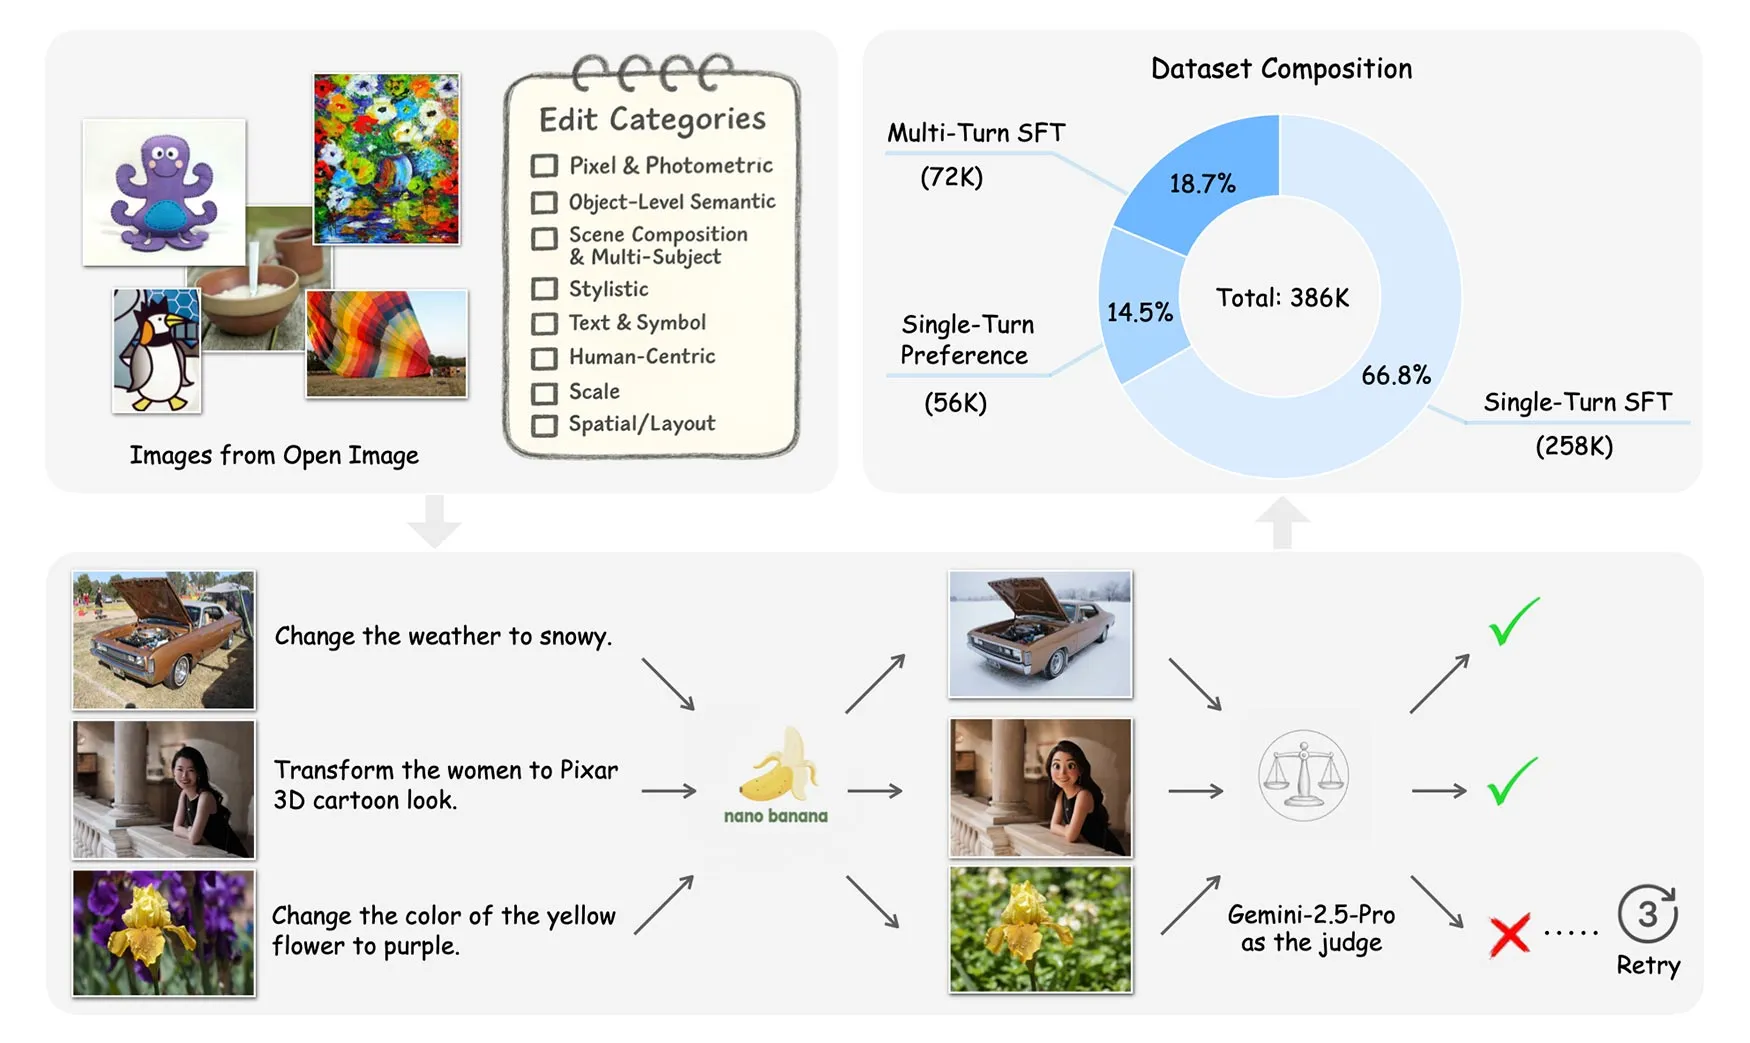
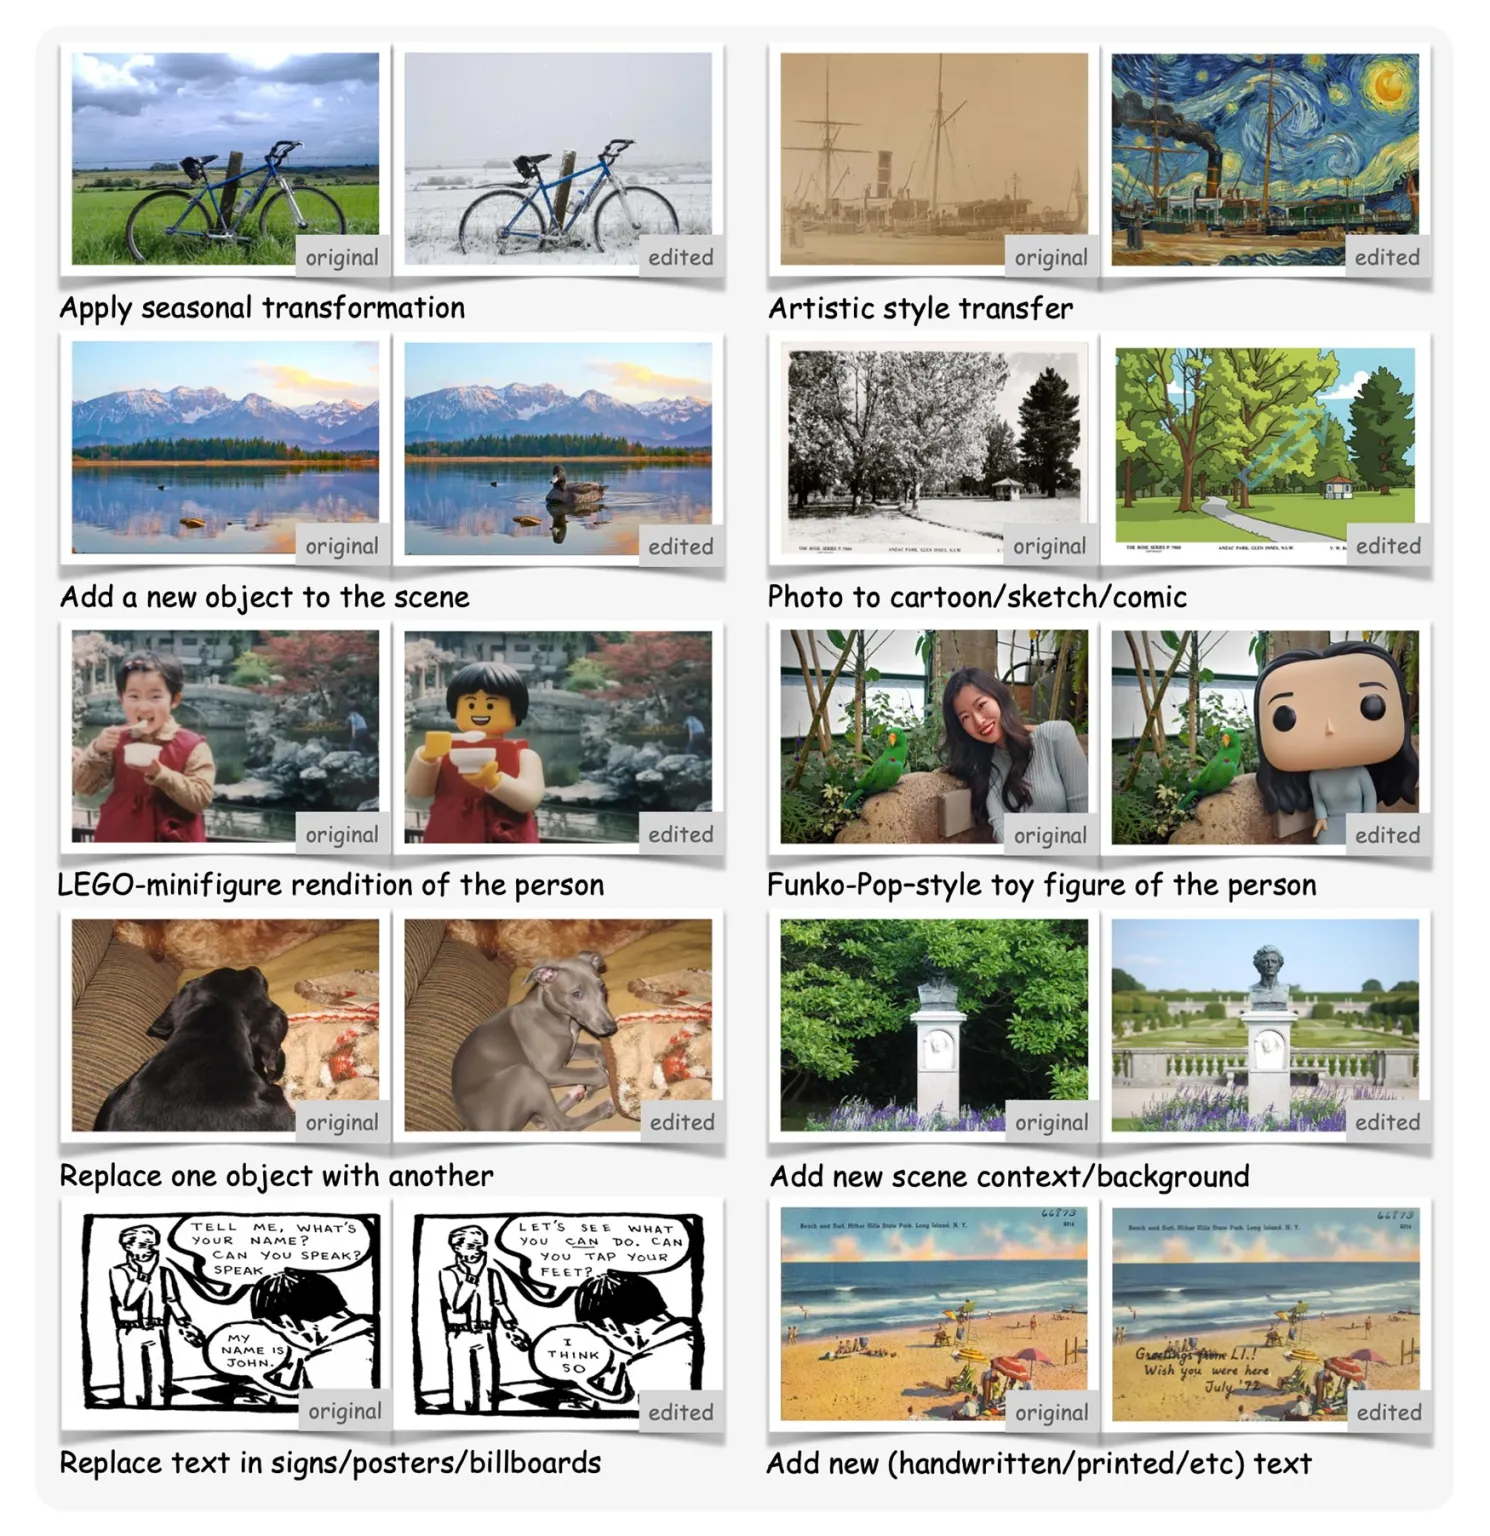
Để xây dựng Pico-Banana-400K, nhóm nghiên cứu Apple đã chọn lọc hàng loạt hình ảnh thật từ bộ dữ liệu OpenImages, bao phủ nhiều chủ đề từ con người, vật thể cho đến bối cảnh văn bản. Sau đó, nhóm định nghĩa 35 loại chỉnh sửa khác nhau, được chia thành tám nhóm chính. Một số ví dụ tiêu biểu gồm:
- Pixel & Photometric: Thêm hiệu ứng hạt phim, áp dụng bộ lọc cổ điển hoặc giả lập ánh sáng tự nhiên.
- Human-centric: Tạo phiên bản nhân vật theo phong cách Funko-Pop hoặc biến đổi ngoại hình nhẹ.
- Scene composition: Thay đổi điều kiện thời tiết như nắng, mưa hoặc tuyết để điều chỉnh bối cảnh.
- Object-level semantic: Di chuyển vật thể, thay đổi kích thước hoặc mối quan hệ không gian trong khung hình.
Mỗi hình ảnh được xử lý bằng mô hình Gemini-2.5-Flash-Image (còn được gọi là Nano-Banana) để tạo ra phiên bản đã chỉnh sửa theo yêu cầu. Kết quả này sau đó được mô hình Gemini-2.5-Pro đánh giá, phê duyệt hoặc loại bỏ dựa trên mức độ tuân thủ hướng dẫn và chất lượng hình ảnh. Quá trình hai bước này giúp đảm bảo dữ liệu đầu ra vừa phong phú vừa nhất quán.
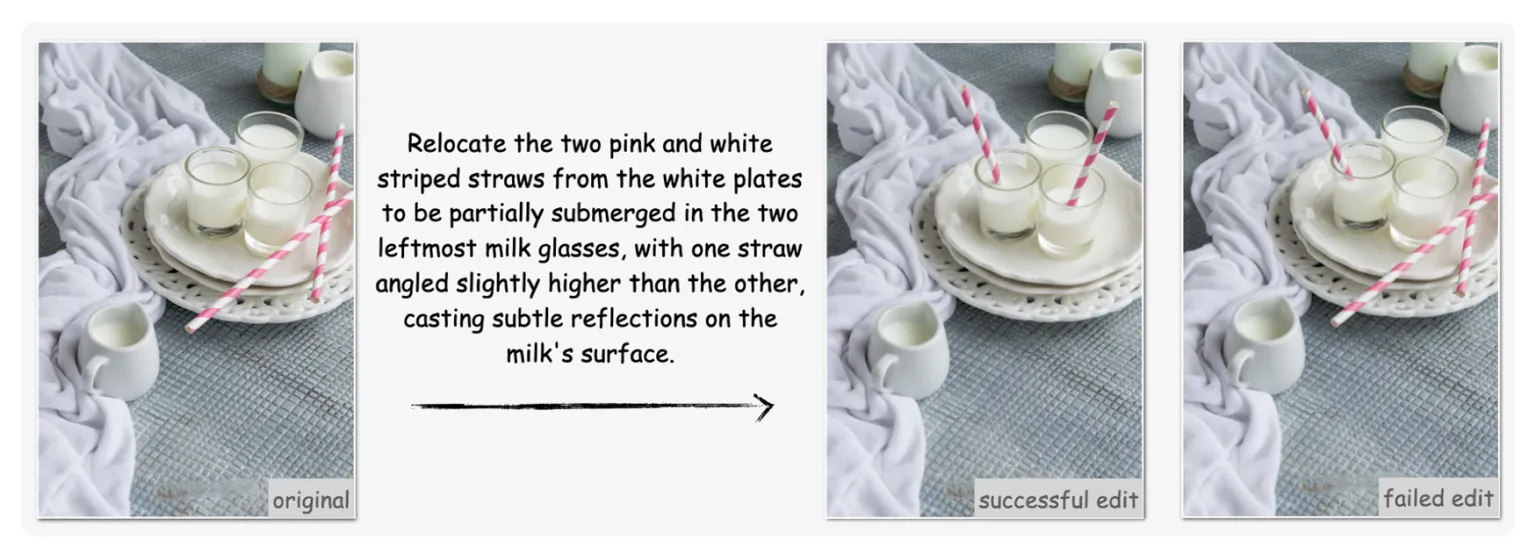
Bộ dữ liệu cuối cùng bao gồm cả những chỉnh sửa đơn lượt (single-turn), nhiều lượt liên tiếp (multi-turn) và các cặp kết quả để mô hình học cách phân biệt giữa hình ảnh đạt và không đạt. Dù thừa nhận mô hình Nano-Banana vẫn còn hạn chế ở khả năng bố cục chi tiết và xử lý chữ trong ảnh, Apple cho rằng Pico-Banana-400K sẽ là nền tảng mở quan trọng giúp cộng đồng nghiên cứu phát triển thế hệ mô hình chỉnh sửa ảnh thông minh hơn trong tương lai. Bộ dữ liệu và bài nghiên cứu hiện đã được công khai trên GitHub.