
Nghiên cứu mới của Apple cho thấy hãng đang tiếp tục đẩy mạnh phát triển các mô hình AI đa phương thức (multimodal LLM), tập trung vào khả năng hiểu hình ảnh, tạo hình ảnh và tìm kiếm thông tin dựa trên hình ảnh. Các nghiên cứu này phản ánh hướng đi dài hạn của Apple trong việc xây dựng nền tảng AI lõi, thay vì chỉ giới hạn ở các tính năng sản phẩm trước mắt.
Trước đó, với iOS 18, Apple đã cho phép tạo hình ảnh trực tiếp trên iPhone thông qua các mô hình AI chạy cục bộ, tiêu biểu là Image Playground. Nay, các nghiên cứu mới tiếp tục mở rộng cách AI của Apple xử lý hình ảnh trong nhiều ngữ cảnh phức tạp hơn, bao gồm tìm kiếm web và suy luận đa bước.
DeepMMSearch-R1: Cách AI của Apple dùng ảnh đã cắt để tìm kiếm web chính xác hơn
Trong nghiên cứu mang tên DeepMMSearch-R1, Apple tập trung vào việc cải thiện khả năng tìm kiếm web của các mô hình AI đa phương thức. Theo các nhà nghiên cứu, nhiều mô hình hiện nay dễ trả lời sai hoặc không trả lời được khi truy vấn liên quan đến hình ảnh, do không xác định đúng phần nội dung quan trọng trong ảnh.
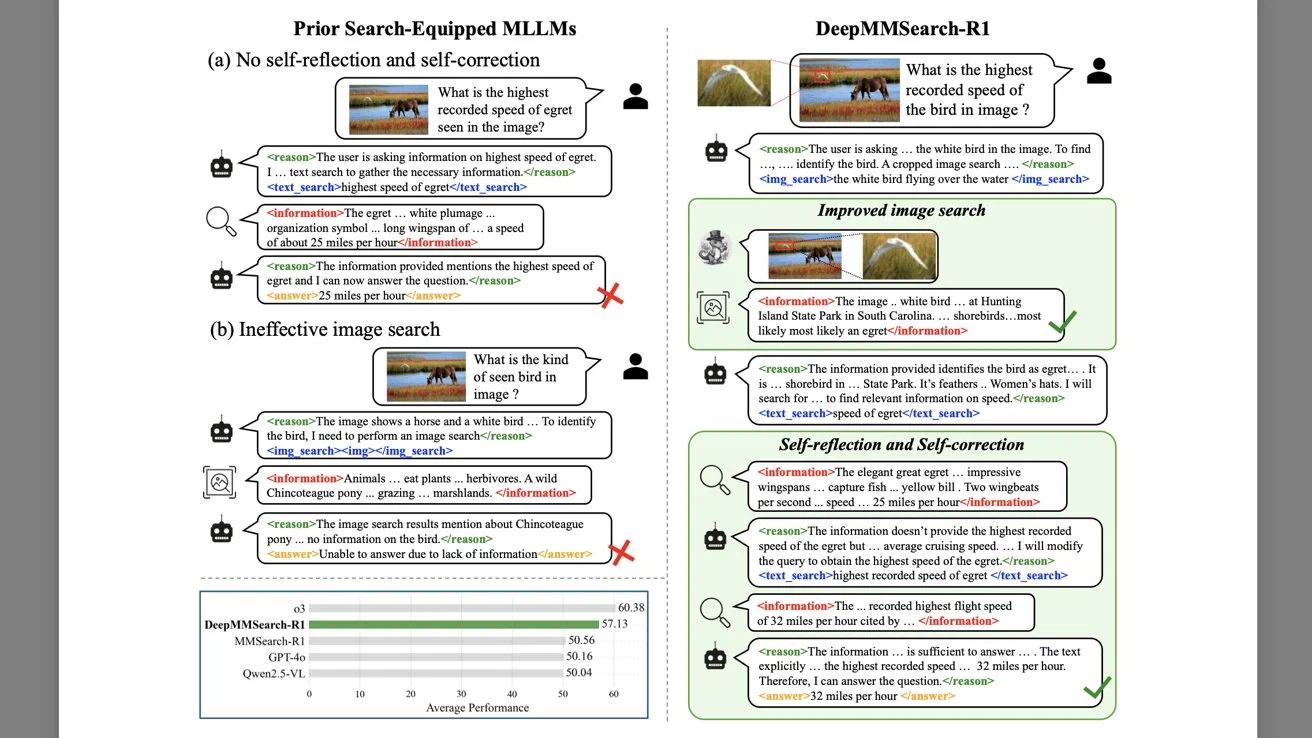
Apple minh họa vấn đề này bằng các ví dụ cụ thể, như việc AI tìm sai thông tin về tốc độ cao nhất của một loài chim do chỉ khớp từ khóa, hoặc không xác định được đối tượng chính khi trong ảnh có nhiều chủ thể khác nhau.
Để khắc phục, DeepMMSearch-R1 được thiết kế với khả năng tự động cắt hình ảnh, chỉ giữ lại vùng liên quan nhất trước khi tiến hành tìm kiếm. Mô hình sau đó kết hợp tìm kiếm hình ảnh và tìm kiếm văn bản để xác thực thông tin, đảm bảo kết quả trả về đúng với yêu cầu truy vấn.
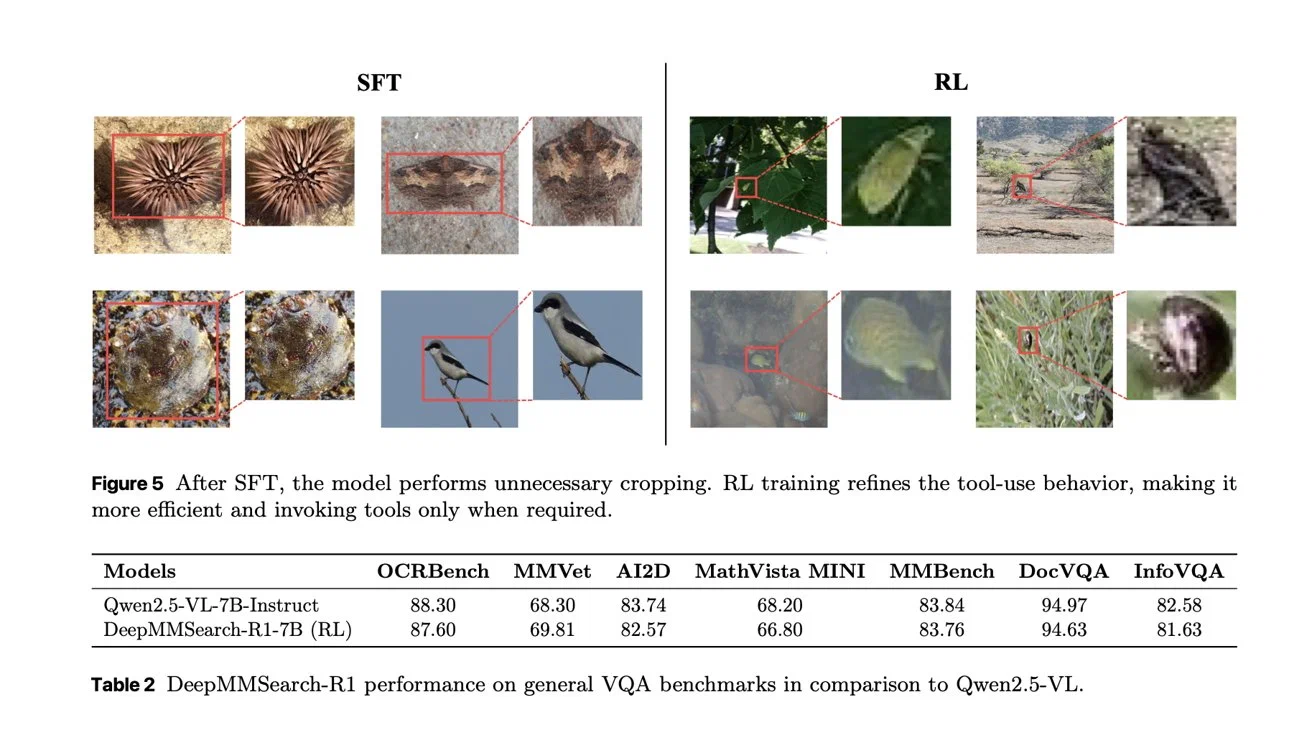
Theo mô tả, hệ thống bao gồm công cụ tìm kiếm văn bản, công cụ cắt ảnh để làm rõ ngữ cảnh và công cụ tìm kiếm hình ảnh. Mô hình được huấn luyện qua hai giai đoạn, nhằm hạn chế việc cắt ảnh không cần thiết và tối ưu cách sử dụng các công cụ tìm kiếm.
Apple cho biết DeepMMSearch-R1 vượt trội hơn các phương pháp tìm kiếm đa phương thức hiện có trong các bài kiểm tra nội bộ, và có tiềm năng ứng dụng trong các hệ thống trợ lý số, giáo dục và tác vụ tìm kiếm thông tin thực tế.
Manzano: Mô hình AI của Apple vừa hiểu vừa tạo ảnh mà không đánh đổi chất lượng
Nghiên cứu thứ hai, mang tên Manzano, tập trung vào việc xây dựng một mô hình AI đa phương thức có thể vừa hiểu nội dung hình ảnh vừa tạo ra hình ảnh mới, mà không cần ưu tiên hay đánh đổi giữa hai khả năng này.
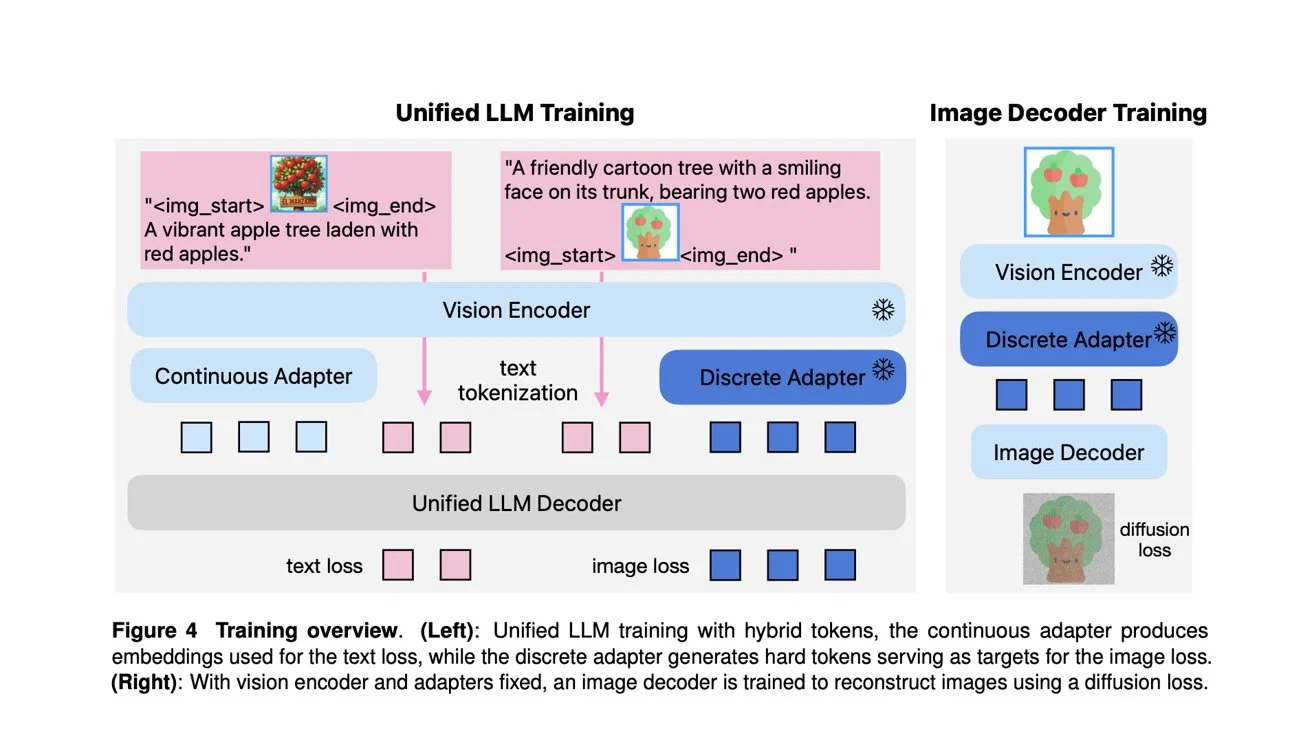
Theo Apple, nhiều mô hình hiện nay thường thiên về một nhiệm vụ, dẫn đến suy giảm hiệu quả ở nhiệm vụ còn lại. Manzano được thiết kế để giải quyết vấn đề này bằng cách sử dụng một bộ mã hóa hình ảnh thống nhất, kết hợp các thành phần phục vụ cả hiểu và tạo ảnh.
Cấu trúc của Manzano gồm bộ mã hóa hình ảnh dùng chung, một bộ giải mã ngôn ngữ có thể xử lý cả văn bản lẫn biểu diễn hình ảnh, và một bộ giải mã hình ảnh để tái tạo ảnh đầu ra. Cách tiếp cận này cho phép mô hình học đồng thời nhiều dạng dữ liệu khác nhau.
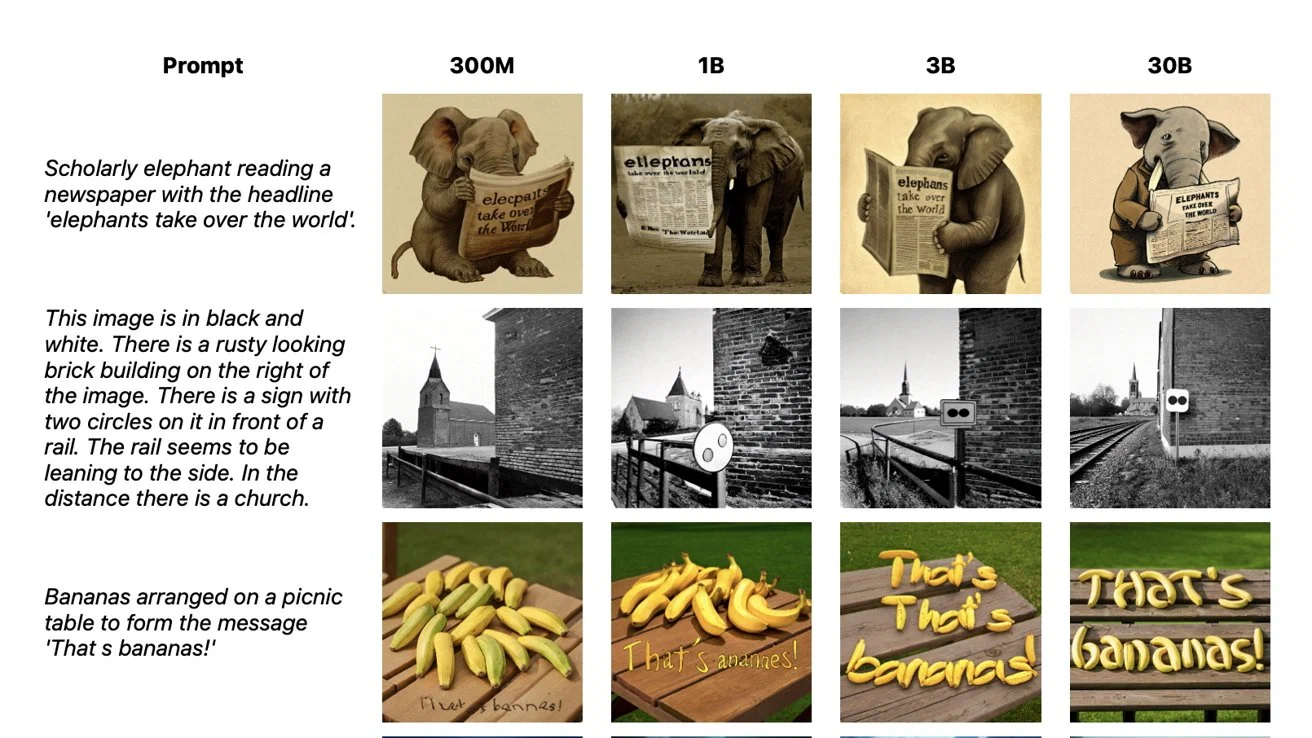
Apple cho biết Manzano đạt hiệu suất cao trong cả nhiệm vụ hiểu và tạo ảnh, kể cả với các phiên bản mô hình có quy mô nhỏ. Khi tăng kích thước mô hình, hiệu quả tiếp tục được cải thiện và cạnh tranh với các mô hình đa phương thức tiên tiến khác.
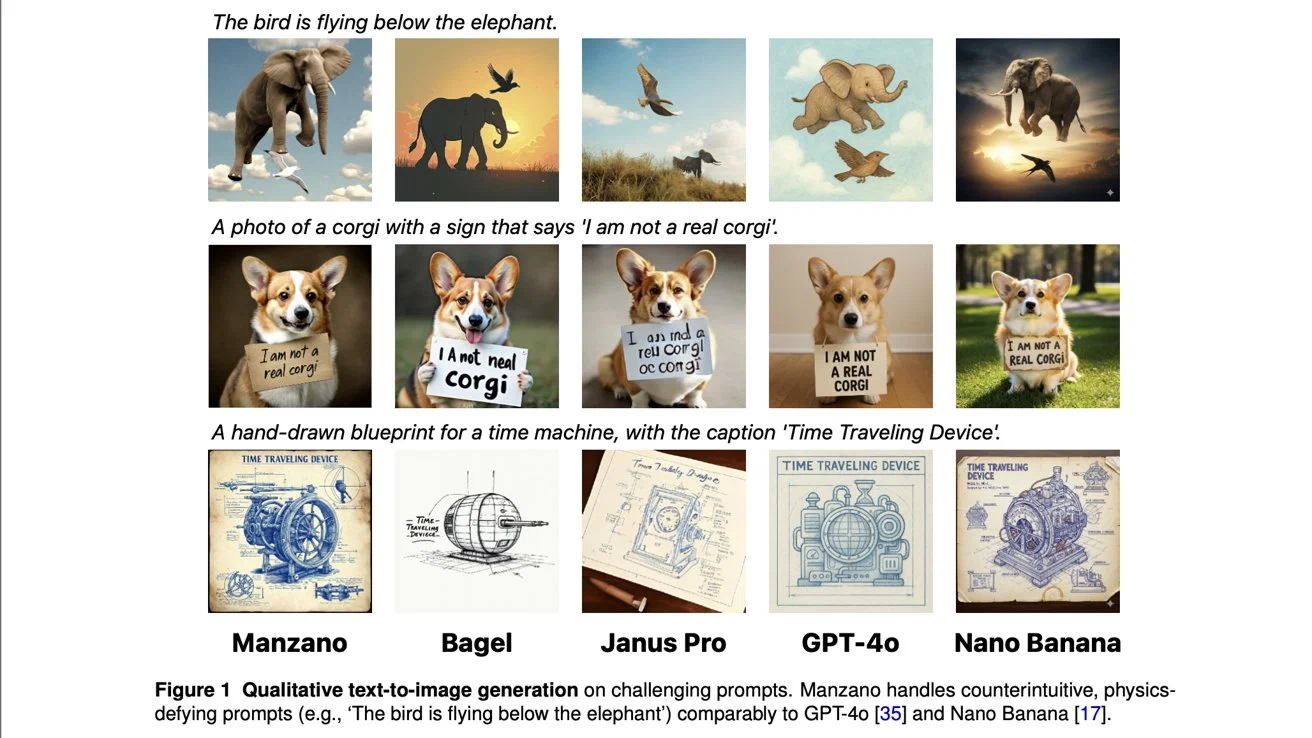
Ngoài việc tạo ảnh, Manzano còn hỗ trợ chỉnh sửa hình ảnh theo chỉ dẫn, chuyển đổi phong cách, điền phần thiếu trong ảnh và xử lý các yêu cầu mang tính phi trực quan. Apple cho rằng kết quả này cho thấy một mô hình AI đa phương thức thống nhất vẫn có thể đạt chất lượng cao mà không cần tách riêng các hệ thống chuyên biệt.