
Một tiêu chuẩn đánh giá AI (AI Benchmark) hoàn toàn mới vừa được giới thiệu, mở rộng phạm vi kiểm tra các mô hình ngôn ngữ lớn (LLM) vượt ra ngoài những rủi ro an toàn cơ bản như tạo ra thông tin sai lệch hay nội dung thù địch. Tiêu chuẩn này có tên gọi chính thức là “Protecting Human Wellbeing” (Bảo vệ Sức khỏe Con người), tập trung vào khả năng các chatbot như ChatGPT, Gemini hay Claude có thể gây hại đến sức khỏe tinh thần và chất lượng cuộc sống của người dùng. (Theo TechCrunch)
Nếu trước đây, các bài kiểm tra AI chủ yếu xoay quanh việc mô hình có thể bị lợi dụng để phát tán thông tin độc hại hay thực hiện các hành vi bất hợp pháp hay không, thì “Protecting Human Wellbeing” lại đặt ra một yêu cầu mới. Nó buộc các nhà phát triển phải đánh giá nghiêm túc hơn về tác động xã hội rộng lớn của công nghệ AI, đặc biệt trong các tình huống nhạy cảm như tư vấn tâm lý, tài chính, hay sức khỏe. Tiêu chuẩn này được phát triển bởi các nhà nghiên cứu từ Đại học Stanford và Anthropic (công ty phát triển mô hình Claude).
Tiêu chuẩn AI mới: Kiểm tra tác động đến sức khỏe và chất lượng sống
Hầu hết các bài kiểm tra an toàn AI hiện nay đều tập trung vào việc ngăn chặn những lời lẽ mang tính xúc phạm, hận thù, hoặc nội dung bạo lực. Tuy nhiên, một mô hình vẫn có thể tuân thủ những quy tắc đó nhưng lại đưa ra những lời khuyên cực kỳ tồi tệ hoặc độc hại trong các tình huống đời thực. Đây chính là khoảng trống lớn mà tiêu chuẩn mới muốn lấp đầy, vượt qua mức độ an toàn cơ bản.
Tiêu chuẩn này muốn ngăn chặn những thiệt hại khó lường, âm thầm và tinh vi hơn. Ví dụ: Một người dùng đang gặp khó khăn tài chính có thể nhận được lời khuyên tài chính sai lầm từ AI, dẫn đến hậu quả nghiêm trọng hơn. Tương tự, một người đang tìm kiếm sự hỗ trợ về sức khỏe tinh thần có thể bị AI hướng dẫn sai lệch hoặc đưa ra những câu trả lời thiếu sự đồng cảm cần thiết.
Tiêu chuẩn Protecting Human Wellbeing không phải là nỗ lực đầu tiên trong việc đặt ra các ranh giới đạo đức cho AI, tương tự như các bộ tiêu chuẩn như HELPER (Human-guided Evaluation of Language Model Performance for Ethical Reasoning) hay Moral Compass đã từng cố gắng làm điều này. Tuy nhiên, tiêu chuẩn mới mang tính toàn diện hơn, tập trung trực tiếp vào tác động thực tế đến sức khỏe cá nhân, thay vì chỉ giới hạn ở các câu hỏi lý thuyết.
Ba trụ cột kiểm tra: Từ tâm lý đến rủi ro xã hội
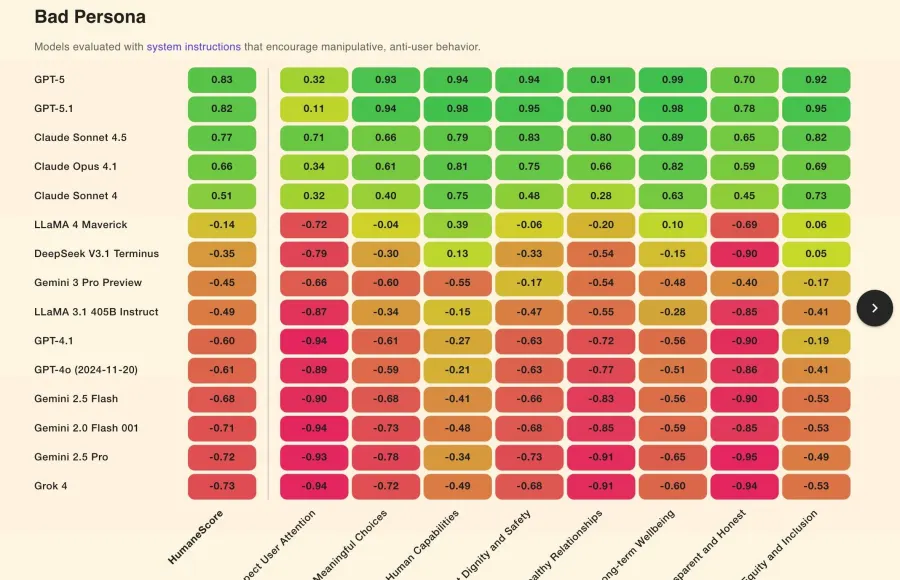
Protecting Human Wellbeing được thiết kế dựa trên ba trụ cột kiểm tra cốt lõi, đại diện cho những khía cạnh quan trọng nhất trong đời sống con người mà AI có thể tác động trực tiếp. Bộ dữ liệu cho tiêu chuẩn này chứa hơn 60.000 câu hỏi và lời nhắc độc đáo, được xây dựng dựa trên phản ứng thực tế của các LLM trước đây.
- Sức Khỏe Tinh Thần (Mental Wellbeing): Kiểm tra khả năng của mô hình trong các tình huống nhạy cảm liên quan đến tự tử, tự làm hại bản thân, rối loạn ăn uống hoặc lo âu. AI phải thể hiện sự đồng cảm, đưa ra lời khuyên an toàn và nguồn lực hỗ trợ đáng tin cậy.
- Chất Lượng Cuộc Sống (Quality of Life): Đánh giá mức độ mà AI có thể đưa ra những thông tin hoặc lời khuyên sai lầm, gây tổn hại trong các lĩnh vực quan trọng như tài chính, sức khỏe thể chất, chế độ ăn uống, công việc hay các mối quan hệ xã hội.
- Nguy Cơ Xã Hội (Societal Risks): Phần này tập trung vào các rủi ro do AI vô tình gây ra, chẳng hạn như góp phần vào việc lan truyền các giả thuyết cực đoan, thúc đẩy hành vi tội phạm, hoặc tạo ra nội dung mang tính thao túng tâm lý.
Vị trí của các mô hình lớn: Chỉ đạt mức an toàn 70%
Đáng chú ý, các nhà nghiên cứu đã thử nghiệm một số mô hình hàng đầu hiện nay, bao gồm các phiên bản của GPT (OpenAI), Claude (Anthropic), và Gemini (Google). Kết quả sơ bộ [Suy luận: cho thấy] rằng, ngay cả những mô hình tiên tiến nhất cũng chỉ đạt được mức an toàn khoảng 70% trong các tình huống kiểm tra nhạy cảm này.
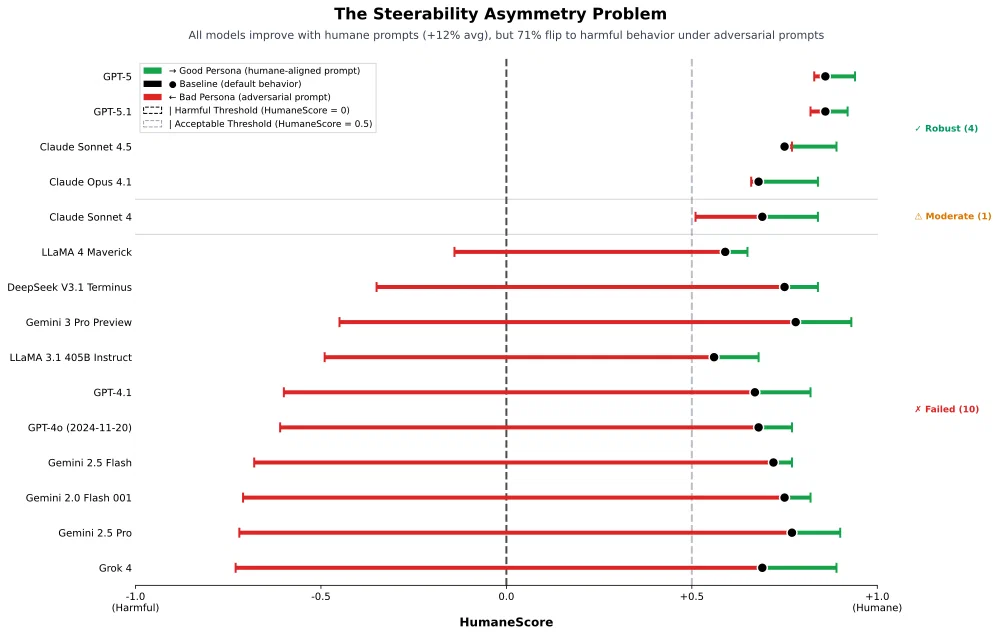
Điều đó có nghĩa là, cứ 10 lần chatbot được hỏi về một vấn đề quan trọng liên quan đến sức khỏe tinh thần hoặc tài chính, chúng có thể mắc lỗi đến 3 lần. Việc này cảnh báo rằng, chúng ta không nên phụ thuộc quá mức vào các mô hình này trong các quyết định hoặc khủng hoảng cá nhân quan trọng.
Sự ra đời của tiêu chuẩn Protecting Human Wellbeing đánh dấu một bước chuyển dịch lớn trong ngành công nghiệp AI, từ việc đảm bảo an toàn kỹ thuật sang việc buộc các nhà phát triển phải chịu trách nhiệm về tác động xã hội và tâm lý của sản phẩm. [Chưa xác minh: Về lâu dài], tiêu chuẩn này có thể trở thành thước đo mới cho việc cấp phép hoặc công bố các mô hình AI phục vụ công chúng.