
Apple vừa công bố dữ liệu thử nghiệm mới cho thấy sự khác biệt đáng kể giữa M5 và M4 khi chạy các mô hình ngôn ngữ lớn trực tiếp trên máy. Thông tin này được chia sẻ qua blog Machine Learning Research, nơi Apple giải thích rõ cách M5 xử lý LLM nhanh hơn, từ token đầu tiên cho đến tốc độ sinh tiếp theo, dựa trên nền tảng MLX. Đây cũng là lần hiếm hoi Apple đưa số liệu so sánh chi tiết giữa hai thế hệ chip.
MLX và bối cảnh của thử nghiệm
Vài năm trước, Apple giới thiệu MLX – framework mã nguồn mở dành cho học máy trên Apple silicon. MLX được thiết kế theo hướng quen thuộc với cộng đồng AI nhờ API tương tự NumPy, hỗ trợ từ mô phỏng số cho đến huấn luyện và suy luận mô hình. Quan trọng hơn, MLX tận dụng kiến trúc bộ nhớ thống nhất, cho phép CPU và GPU cùng truy cập dữ liệu mà không phải sao chép liên tục.
MLX LM, gói mở rộng chuyên cho mô hình ngôn ngữ, cho phép tải và chạy đa số mô hình trên Hugging Face trực tiếp trên máy Mac. Framework này cũng hỗ trợ quantization, giúp giảm mức tiêu thụ bộ nhớ và tăng tốc độ sinh văn bản, phù hợp với những mô hình lớn 8B, 14B, hoặc các kiến trúc Mixture of Experts.
M5 vs M4: Hiệu năng LLM tăng bao nhiêu?
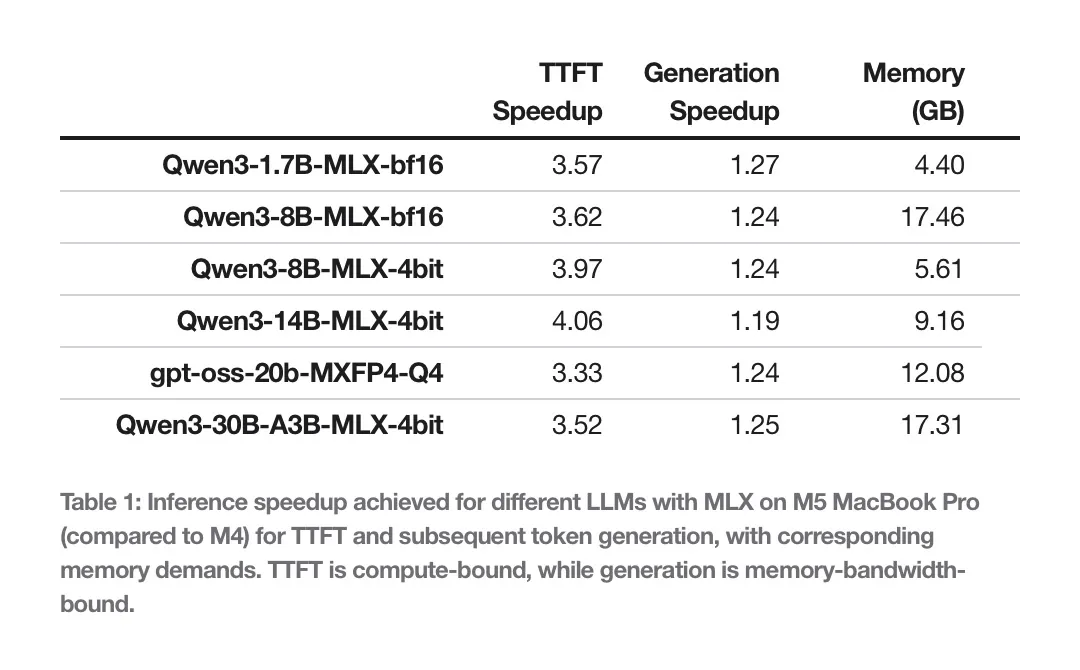
Trong bài thử nghiệm mới, Apple sử dụng MLX LM để đo thời gian sinh token đầu tiên và tốc độ sinh 128 token tiếp theo trên nhiều mô hình mở, gồm Qwen 1.7B, 8B, Qwen 14B dạng 4-bit, MoE Qwen 30B và GPT OSS 20B. Tất cả đều dùng chung prompt 4096 token.
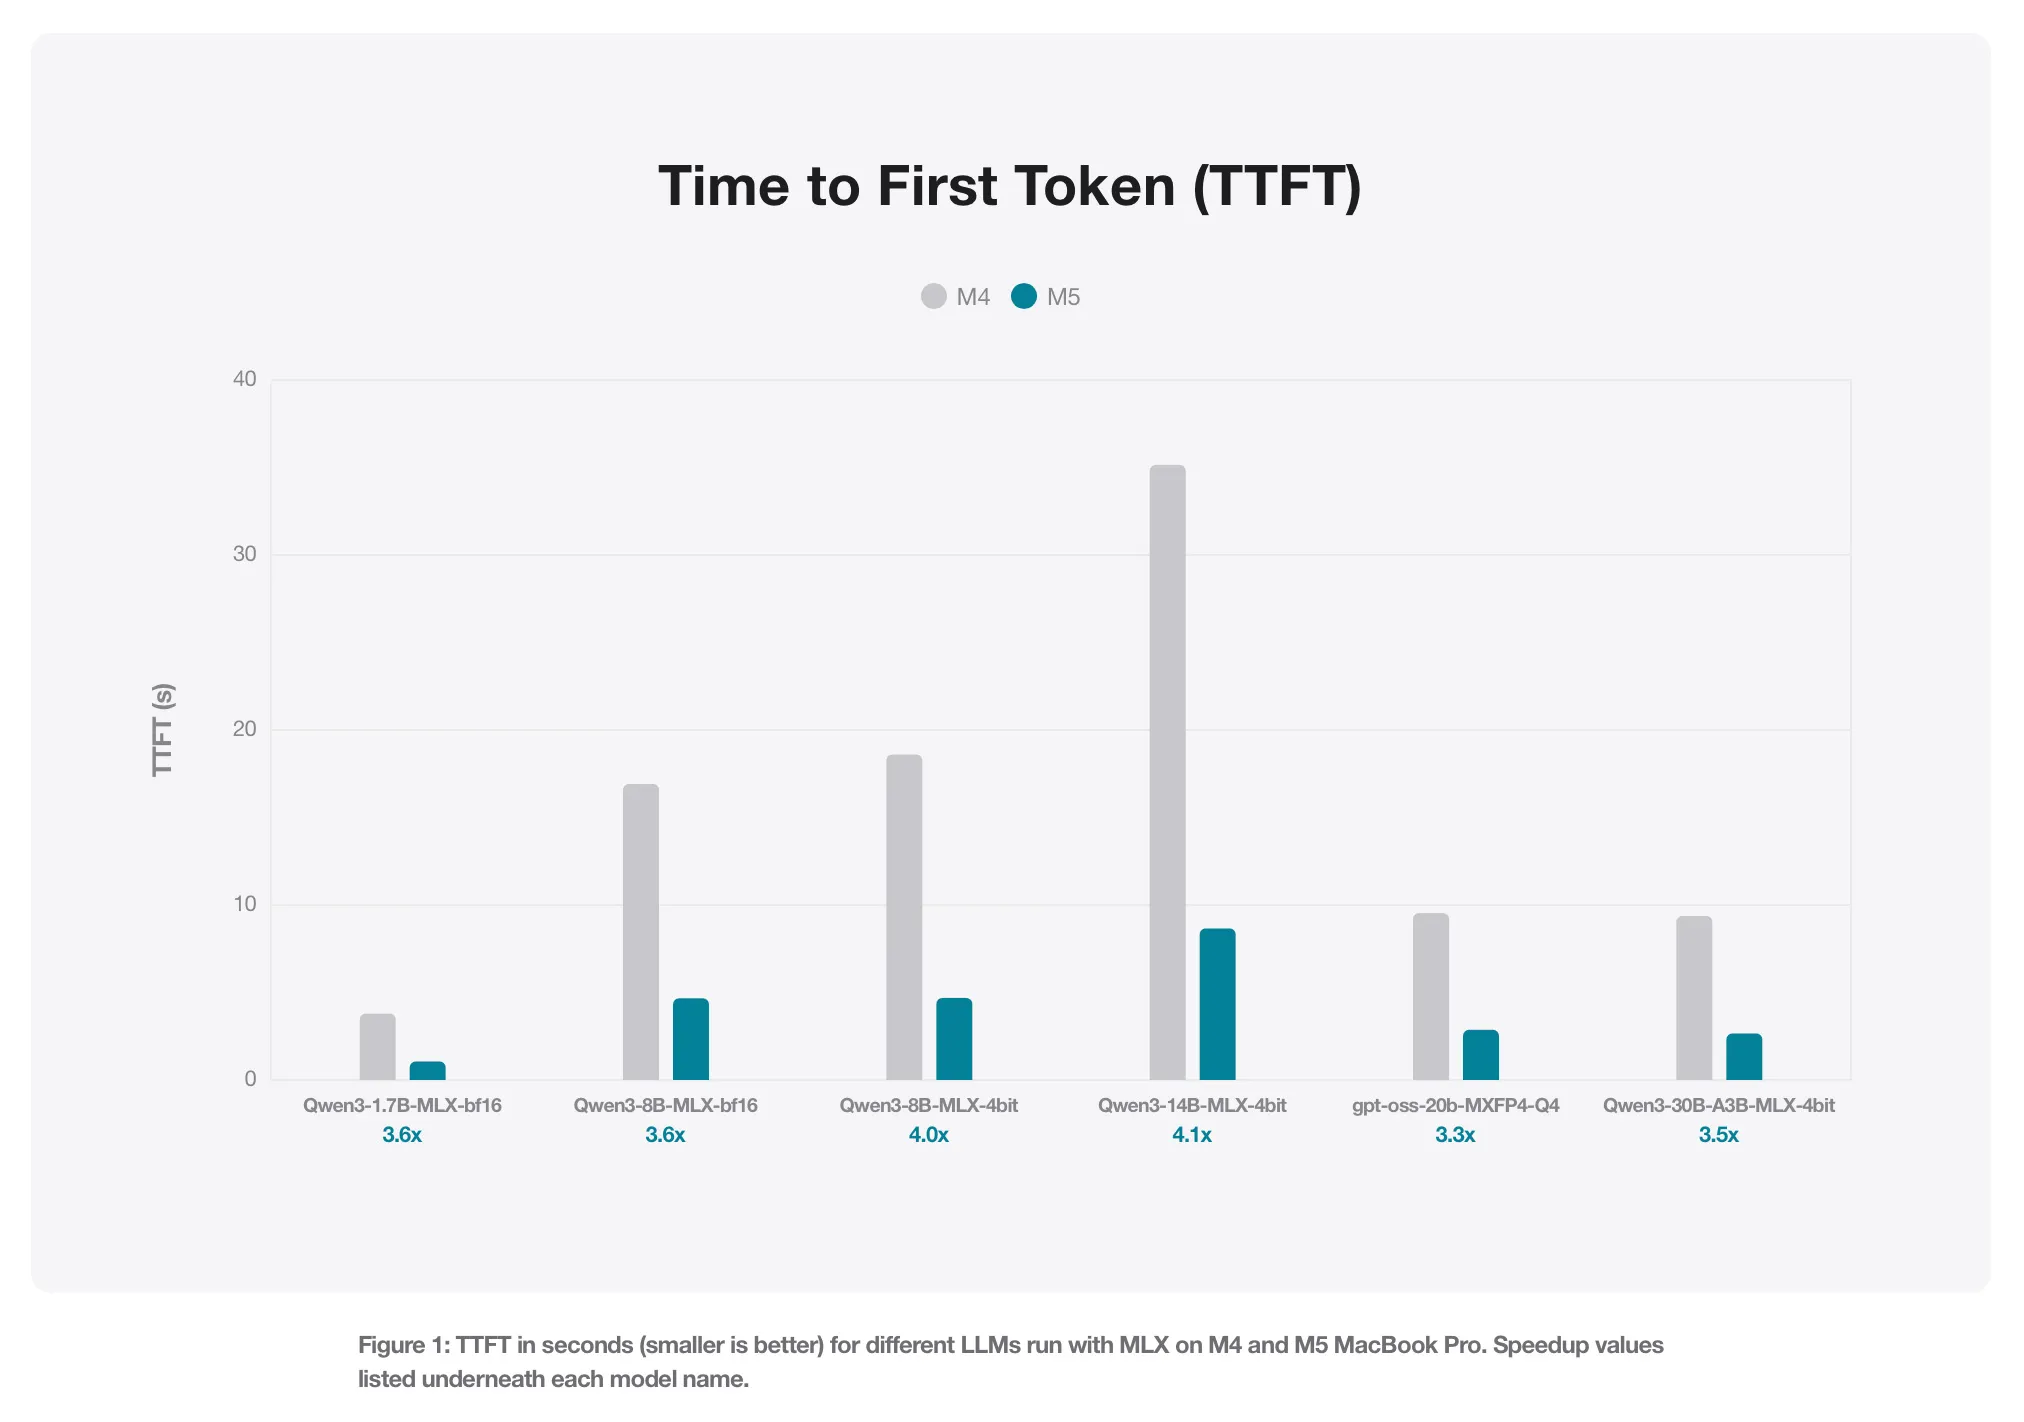
Token đầu tiên là bước nặng tính toán, trong khi các token sau lại phụ thuộc nhiều vào băng thông nhớ. Đây cũng là nơi kiến trúc mới của M5 tỏ rõ ưu thế nhờ GPU Neural Accelerators, bổ sung các phép nhân ma trận dành riêng cho tác vụ AI, đồng thời tăng băng thông bộ nhớ lên 153GB/s – cao hơn 28% so với 120GB/s của M4.
Dựa trên các phép đo, M5 cho tốc độ sinh token cao hơn khoảng 19–27% so với M4 tùy mô hình. Các bài test cũng cho thấy MacBook Pro với 24GB RAM có thể chạy trơn tru mô hình 8B dạng BF16 hoặc MoE 30B dạng 4-bit với mức dùng bộ nhớ dưới 18GB – phù hợp cho tác vụ LLM cục bộ.
Tác vụ hình ảnh và những gì kết quả thể hiện
Bên cạnh LLM, Apple còn thử nghiệm khả năng sinh ảnh. Ở tác vụ này, M5 thể hiện bước nhảy lớn hơn nhiều: Tốc độ xử lý nhanh hơn 3.8 lần so với M4. Điều này củng cố hướng đi của Apple khi tập trung vào phần tăng tốc GPU dành cho AI thay vì mở rộng số nhân CPU như trước.
Dù chia sẻ chỉ dừng lại ở một vài mô hình và kịch bản thử nghiệm, dữ liệu lần này cho thấy Apple silicon đang được chỉnh hướng mạnh sang tác vụ AI cục bộ, từ bộ nhớ, GPU cho đến phần mềm MLX. Apple hứa hẹn sẽ tiếp tục bổ sung thêm ví dụ, tối ưu và công cụ giúp MLX tận dụng toàn bộ kiến trúc M5 trong các ghi chú kỹ thuật tiếp theo.